



 人民网+
 中国共产党新闻网
 领导留言板
 强国论坛
 人民视频
中国联通:算力接好线,AI不断线
 订阅已订阅已收藏
 收藏
 小字号
AI应用越来越火。做海报、列行程、点咖啡,一句话就能办成事。可很多人不知道,收到的每一条AI回复,背后都有算力在“跑腿”。
算力从哪来?怎么送得到、调得动、算得准?带着这串问号,记者走进2026“互联网之光”博览会中国联通展台,探究这条“看不见的算力生产线”是如何运转的。
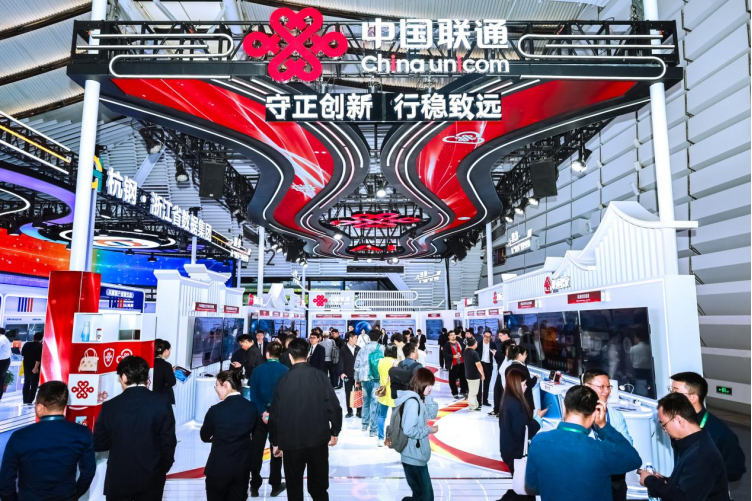
中国联通亮相2026世界互联网大会乌镇峰会。中国联通供图
修通算力的“智能高速”
展台入口处,一块AIDN创新架构展板前围了不少观众。AIDN是什么?联通数科云计算架构师杨少毅解释,它是面向新一代通信网与算力深度融合的架构,说白了就是给AI修一条“智能高速公路”,让算力、模型、数据跨域高效互联、统一调度。
过去,算力、模型、数据各在各的地方,互相叫不应。AIDN要做的,就是让它们能跨地方“对话”。依托5G-A、6G、万兆宽带、卫星及低空网络,联通持续打造“一点入算、毫秒用算”的全域接入能力,800G、1.6T超大带宽和广域无损传输,则保证AI训练和推理不掉链子。
杨少毅打了个比方:“再强的武林高手,经脉不通,内功也施展不出来。大带宽就像打通了算力传输的‘任督二脉’,从原来100G拓到1.6T,一次性输出的‘内力’更多,大模型自然跑得更快。”
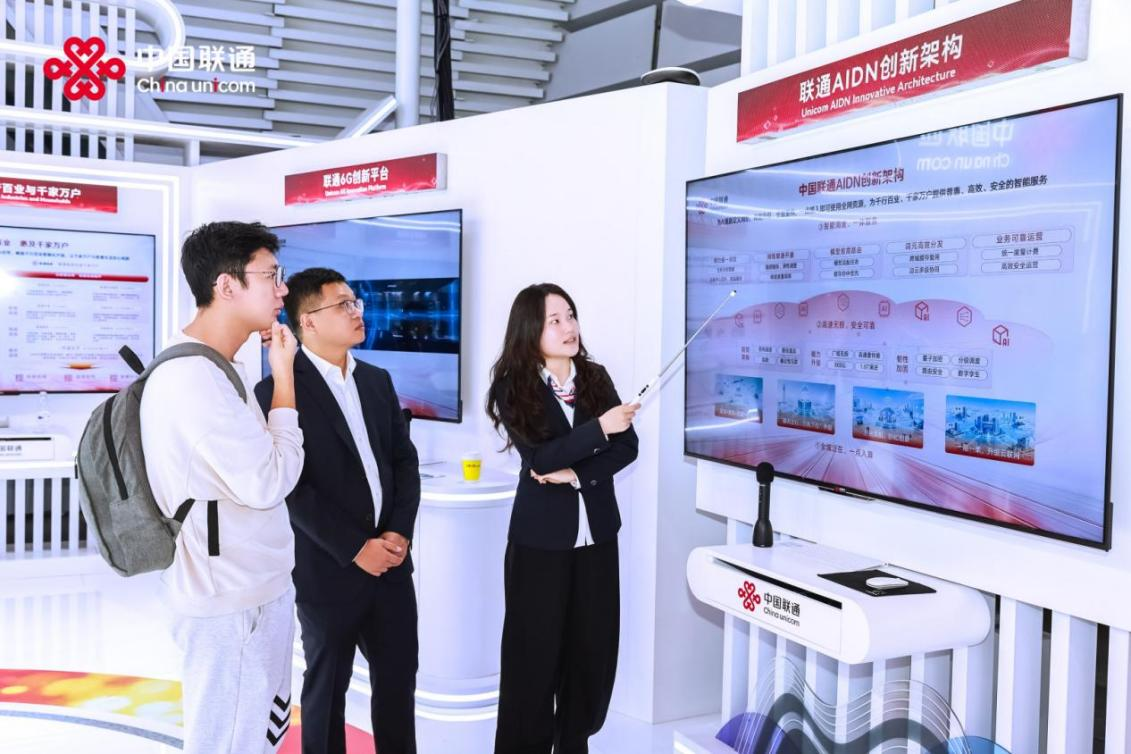
联通展位工作人员为观众介绍AIDN架构。中国联通供图
快是一回事,算力能不能跨地区调度,是另一回事。联通在算力中心之间铺了一张骨干网络,每秒可传输400Gbps的数据,把不同地区的算力资源池连成一张网。
“北京算力不够,任务可以直接送到上海去算,用户不用管机器到底在哪座城市。”杨少毅告诉记者,算力调度时就像打顺风车,会自动判断哪个节点的算力最近、状态最好,把任务送过去。
“眨眼的工夫,差不多能来回调10次算力。”杨少毅说,调度选得准、送得快,用户端才能做到“毫秒用算”。
谁来指挥这些算力?
路修好了,还得有人指挥。当你让AI做一张海报时,平台会先判断这是图像任务,该调图像模型。再看看附近哪个算力中心有空,还要选择哪种芯片跑这类任务更合适,最后选一条最快的网络把任务送过去。这套“派活”的活儿,就是调度。指挥得好,AI回得快、花钱少;选不好,就可能排队,影响效率。
“谁来指挥这些算力?”顺着记者的问题,杨少毅指向展台上的联通云8.0“六算协同”大屏,屏幕上,词元调用数据正实时跳动。
杨少毅告诉记者,“六算协同”是把算力、网络、模型等资源协同起来、统一调度的一套体系。这套体系中,具体给算力“派活”的,就是联通星罗先进算力调度平台。该平台累计词元调用量已达1.9万亿,相当于处理了海量文本,说明这套调度已经在大量真实调用中跑起来。
“它还能把相隔几千公里的多地不同种芯片连起来,一起训练同一个模型。就像分别来自不同城市的工人隔空协作,组装同一台机器。”杨少毅表示,这种协同对大模型训练很关键,“一个地方算力不够,不必干等,可以把任务分出去一起算。”
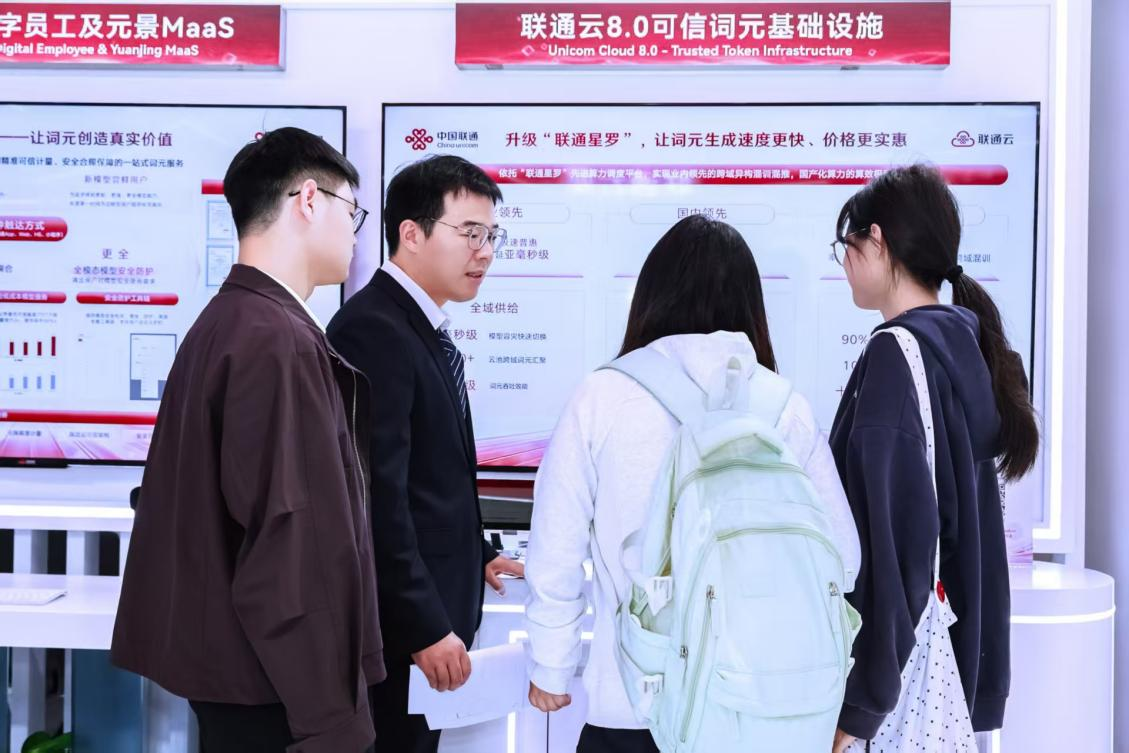
展位工作人员为观众介绍。中国联通供图
推理环节也有提升。“国产推理算效提升7倍以上,原来7小时才能出结果的任务,现在1小时就能完成。这对普通用户来说,最直观的感受就是少等待、少花钱。”杨少毅说。
开一家“AI模型超市”
用户真正要用AI,除了解决算力,还得面对另一个问题:模型这么多,选哪个、怎么用?联通的“元景MaaS”接手了这件麻烦事。
杨少毅告诉记者,元景MaaS就像一个“AI模型超市”,汇聚了超230个主流品牌全模态大模型,采用“自有+第三方”的模型超市模式,配套智能路由与安全防护。用户不用自己挑模型、搭环境,平台帮你挑模型、调模型、确保安全性。
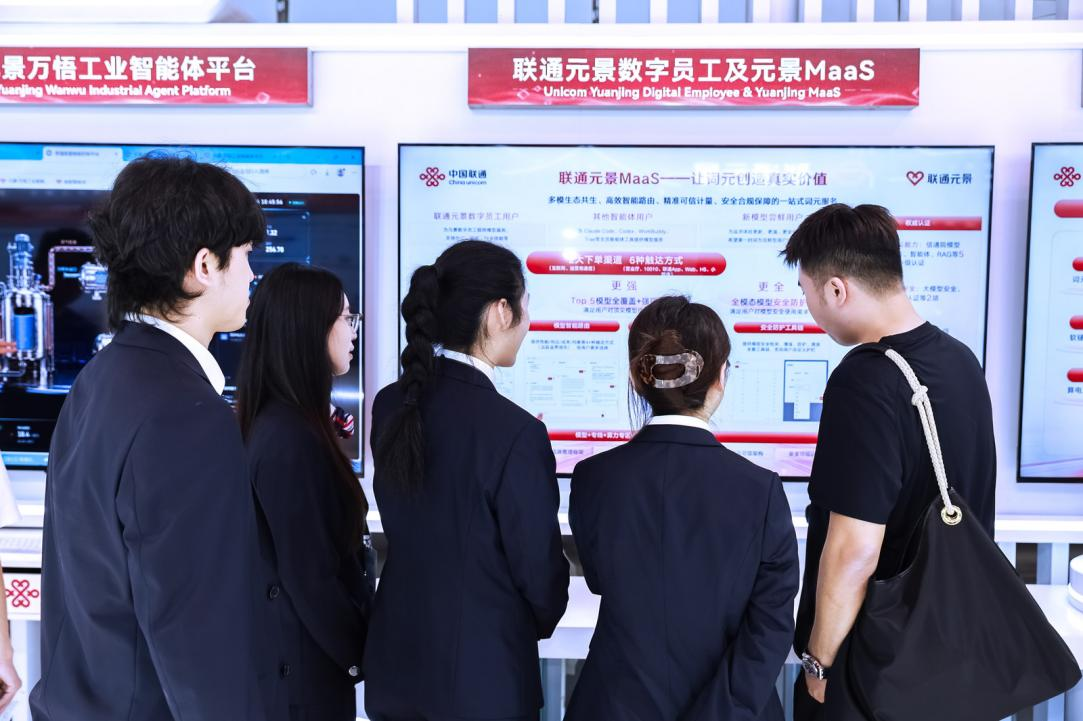
观众在展位咨询。中国联通供图
“先看哪个模型更贴近任务需求,再看哪里调用网络成本更低,还要看芯片更擅长推理还是训练,最后给出一个最优方案。用户按需调用即可,具体的模型匹配和资源调度由平台完成。”杨少毅说。
元景MaaS解决的是“模型怎么选”,但到了工业现场,光有模型还不够,还得让模型融入业务流程。中国联通浙江分公司联合桐昆集团打造的“千品共线”领航工厂,就是一个落地样本:28个工业智能体各管一摊,研发、生产、管理、运营都有AI“上岗”,带动效率提升36%。
记者了解到,这些智能体背后,是联通的三样东西在支撑:元景大模型是基础“大脑”,万悟工业智能体平台把“大脑”和具体工序拼成能干活儿的智能体;FDE(业务解构者和智能体构建者)则是联通的驻厂团队,进车间拆流程、接数据,让AI真正嵌进产线。
回过头看,这条“算力生产线”已经跑通了关键阶段。杨少毅告诉记者,下一步将继续打磨模型能效、优化权重,并根据不同芯片部署不同模型,网络和调度也将持续优化,让算力真正像水一样,拧开龙头就有。
分享让更多人看到 
 人民日报
 人民网+
 手机人民网
 领导留言板
 人民视频
 人民智作
人民日报社概况 | 关于人民网 | 报社招聘 | 招聘英才 | 广告服务 | 合作加盟 | 供稿服务 | 数据服务 | 网站声明 | 网站律师 | 信息保护 | 联系我们
人民日报违法和不良信息举报电话:010-65363263 举报邮箱:jubao@people.cn
人民网服务邮箱:kf@people.cn 违法和不良信息举报电话:010-65363636 举报邮箱:rmwjubao@people.cn
互联网新闻信息服务许可证10120170001 | 增值电信业务经营许可证B1-20060139 | 广播电视节目制作经营许可证(广媒)字第172号
信息网络传播视听节目许可证0104065 | 网络文化经营许可证 京网文[2020]5494-1075号 | 网络出版服务许可证(京)字121号 | 京ICP证000006号 | 京公网安备11000002000008号
人 民 网 股 份 有 限 公 司 版 权 所 有 ,未 经 书 面 授 权 禁 止 使 用
Copyright © 1997-2026 by www.people.com.cn. all rights reserved
-
评论

-
关注
微信微博快手
 第一时间为您推送权威资讯
 报道全球 传播中国
 关注人民网,传播正能量
